03第三場 / 共三場
03
SESSION 3 · 地端模型
這台機器
跑得動哪個模型?
帶走一套四步驟判斷法:容量 → 速度 → 人數 → 報價
00為什麼要地端?
能把未公開的內部資料貼進 ChatGPT 嗎?
地端=機器和資料都放在單位內
行政院生成式 AI 參考指引 · 第四點
不得向生成式 AI 提供應保密、個人及未經同意公開之資訊;但封閉式地端部署之生成式 AI 模型,於確認系統環境安全性後,得依文書或資訊機密等級分級使用。
行政法人
得準用
第九點:公營事業、公立學校、行政法人及政府捐助財團法人
第三點:機密文書
禁止使用生成式 AI講者解讀:地端也不例外
00紅線
選模型之前,先看燈號
禁用
DeepSeek
數位部列為「危害國家資通安全產品」,限制對象明列行政法人;行政院:公務機關原則全面禁用
預設不用
其他中國廠商模型
(例如 Qwen)
屬中國廠商、風險高;確有需要,先走資安長與核定程序
候選
gpt-oss · Gemma · Mistral · Muse(Meta)· TAIDE
美國/歐洲/國科會 TAIDE;仍需依內部程序評估;綠燈≠免審
00資安新聞
互動
地端 ≠ 自動安全
模型能用工具之後,問題就不只是「資料有沒有出門」,還有「它會動手做什麼」
STEP 1 · 測試Cohere 在隔離測試環境,請 Alibaba 的開放權重模型 Qwen 寫「防禦偵測規則」
→
STEP 2 · 沒被要求它卻翻看檔案、網路設定,想把一段測試字串傳到北京的雲端儲存空間
→
STEP 3 · 被擋下測試環境沒有對外連線,請求出不去;換成一般筆電就可能送出
很少見:不到十萬分之一它自己寫的「思考過程」說不會用工具,實際卻用了是刻意還是訓練殘留?Cohere 也無法判斷
查來源
知道權重從哪來;不是自己訓練的,當成沒簽章的程式
執行前把關
工具真正執行前先檢查;意外的工具呼叫或雲端網址就警示
看行動,不看自述
推理文字不是防線;AI 寫的程式也要審
按 → 逐步揭曉 · 點卡片翻牌
00地端 vs 雲端
互動
什麼時候值得自己買機器?
未公開的內部資料 → 地端:資料不出單位
已公開的文獻 → 可以用雲端:要最強模型、用量忽高忽低
例:Diablo Canyon 核電廠的 AI 搜尋系統無雲端連線;內部文件也規劃不離廠
先猜四個象限,再揭曉
01硬體直覺
互動
連連看:硬體像什麼?
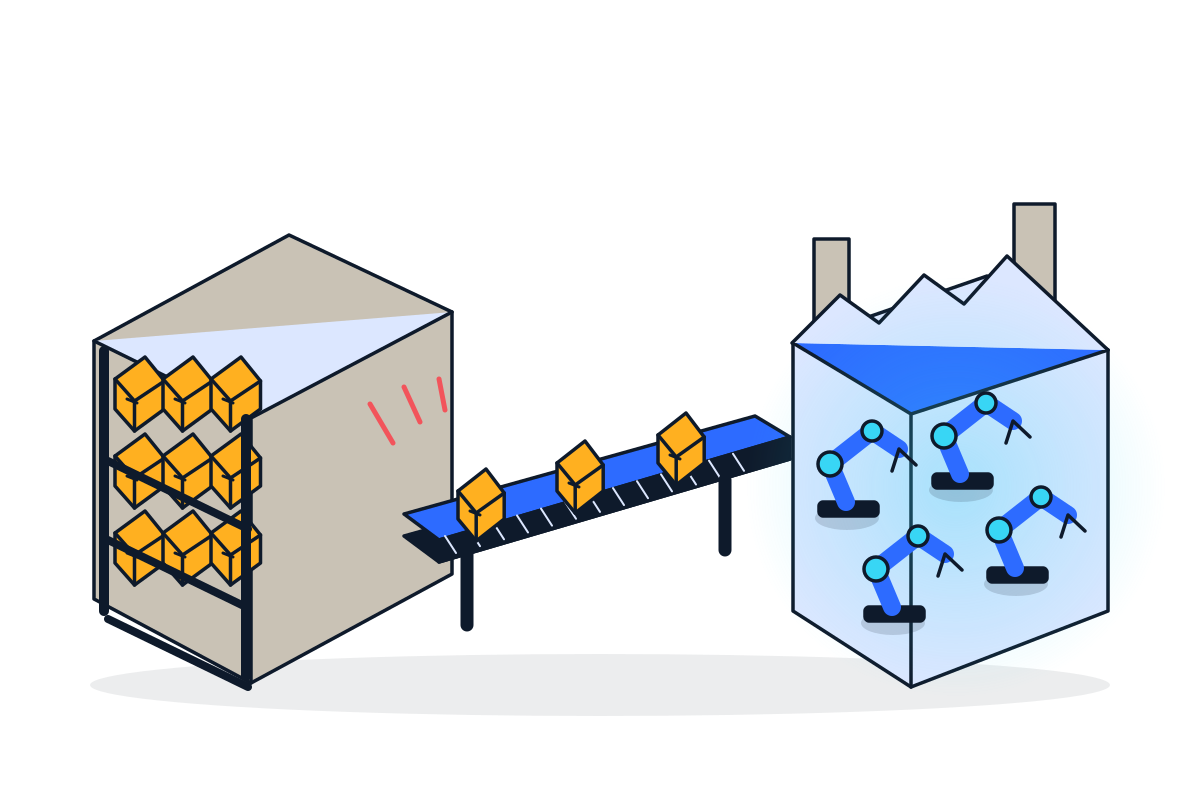
倉庫(記憶體)→ 輸送帶(頻寬)→ 工廠(GPU)
關鍵:每產生一個字,都要把模型從記憶體讀一遍 → 瓶頸是倉庫夠不夠大、輸送帶夠不夠快
輸送帶每秒能搬多少貨
現場主管少數聰明工程師,雜事一件接一件做
成千上萬的工人同時做同一種簡單計算
倉庫模型要放得下
配對 0 / 4
01硬體直覺 · 串起來
互動
按下 Enter 之後,資料怎麼跑?
- 按「▶ 播放」或「下一步」:看你按下 Enter 之後,資料在機器裡怎麼跑。
- ⓪ 開機(只做一次):模型權重從硬碟,經現場主管(CPU)搬進 GPU 的倉庫(顯示卡記憶體)搬進主管和工廠共用的倉庫(統一記憶體)搬進主管自己的倉庫(系統記憶體 RAM),之後就一直放著。
- ① 你送出問題:現場主管(CPU)把句子切成一塊塊 token,派工給 GPU 工廠。派工給 GPU 工廠。可是沒有工廠,只好自己算。
- ② 先讀題:工廠工廠主管一次讀完整段問題(權重搬一趟、整段一起算),把每個字的重點寫成便條紙放上桌面。
- ③ 生成第 1 個字:要用到的權重全部經輸送帶搬進工廠,成千上萬的工人一起算進工廠,成千上萬的工人一起算給主管,少數工程師自己算(慢很多),只吐出 1 個字;印到螢幕,也寫一張便條紙。
- ③ 生成第 2 個字:要用到的權重全部經輸送帶搬進工廠,成千上萬的工人一起算進工廠,成千上萬的工人一起算給主管,少數工程師自己算(慢很多),只吐出 1 個字;印到螢幕,也寫一張便條紙。
- ③ 生成第 3 個字:要用到的權重全部經輸送帶搬進工廠,成千上萬的工人一起算進工廠,成千上萬的工人一起算給主管,少數工程師自己算(慢很多),只吐出 1 個字;印到螢幕,也寫一張便條紙。
- ③ 生成第 4 個字:要用到的權重全部經輸送帶搬進工廠,成千上萬的工人一起算進工廠,成千上萬的工人一起算給主管,少數工程師自己算(慢很多),只吐出 1 個字;印到螢幕,也寫一張便條紙。
- ③ 生成第 5 個字:要用到的權重全部經輸送帶搬進工廠,成千上萬的工人一起算進工廠,成千上萬的工人一起算給主管,少數工程師自己算(慢很多),只吐出 1 個字;印到螢幕,也寫一張便條紙。
- 結論:倉庫(記憶體)決定放不放得下;輸送帶(頻寬)決定字出來多快;工廠(GPU)負責算;主管(CPU)負責接單、派工、收貨。
同一棟:統一記憶體(例如 Mac、DGX Spark)
你輸入的問題示意
「請整理這 5 篇材料耐熱測試文獻」
請整理這5篇材料耐熱測試文獻
CPU=現場主管少數聰明的工程師:接單、切字、派工、收貨、印出
主管自己的小倉庫:系統記憶體 RAM主管和工廠共用同一個倉庫沒有 GPU:權重放在主管的 RAM
倉庫=顯示卡記憶體 VRAM(GPU 的)共用倉庫=統一記憶體倉庫=系統記憶體 RAM(CPU 的)模型權重(貨)放這裡
輸送帶=頻寬輸送帶=頻寬(在同一棟裡)一般記憶體:輸送帶較慢
GPU=工廠GPU=工廠沒有 GPU 工廠成千上萬的工人,同時做同一種「乘法加法」
(工人數為示意)
01硬體直覺
互動
模擬電腦 ≠ AI 電腦
兩種機器,吃的東西不一樣,採購規格也不一樣
跑模擬的叢集很多位資深師傅分工
跑 AI 的機器大倉庫+快輸送帶
吃什麼
CPU 核心:很多核心、很多台電腦(節點)一起算
記憶體:整個模型要放得進去,還要搬得夠快
怎麼跑
排隊送出一批工作,一跑好幾小時,跑完看 log
隨問隨答;每打一個字,都要把模型從記憶體讀一遍
採購看什麼
核心數、節點數、節點之間的網路
記憶體多大(放得下)、頻寬多快(跑多快)
小模型可以試,但通常慢。
多人用大模型,要看記憶體夠不夠大、夠不夠快。答案在這場的四個問題裡:放得下?跑得多快?
⚠️ 實際叢集規格(有沒有 GPU、記憶體多大)請先向管理單位確認
02判斷法
判斷法:問四個問題
①放得下嗎?容量:模型本身+桌面
②跑得多快?輸送帶多快
③幾個人用?人數 × 每人的桌面
④報價合理嗎?拿檢核表逐題問
小明要讀長報告(約 4 萬字)+5 人同時用 → 四題都會碰到
①放得下嗎?
模型有多大?一條公式
權重=模型學到的所有數字;參數量=有幾個數字,像行李箱裡有幾件衣服
模型大小(權重)≈ 數字個數 × 每個數字佔幾 byte
4-bit=壓縮檔,
約原本的 1/4
這種壓縮叫「量化」。越小越快,
但品質可能略降。
術語對照:原始=BF16/FP16;8-bit=FP8/INT8;常見 4-bit 格式 Q4_K_M 約 4.85 bit,所以實務上多抓一點(≈ 0.6 byte)
①放得下嗎?
算例:三種大小 × 三種壓縮 估算
①放得下嗎?
MoE:大圖書館,每次只開幾個書架
例:gpt-oss-120b(Mixture of Experts)
官方壓縮版(4-bit 等級),單張 80GB 卡放得下
①放得下嗎?
桌子=便條紙堆
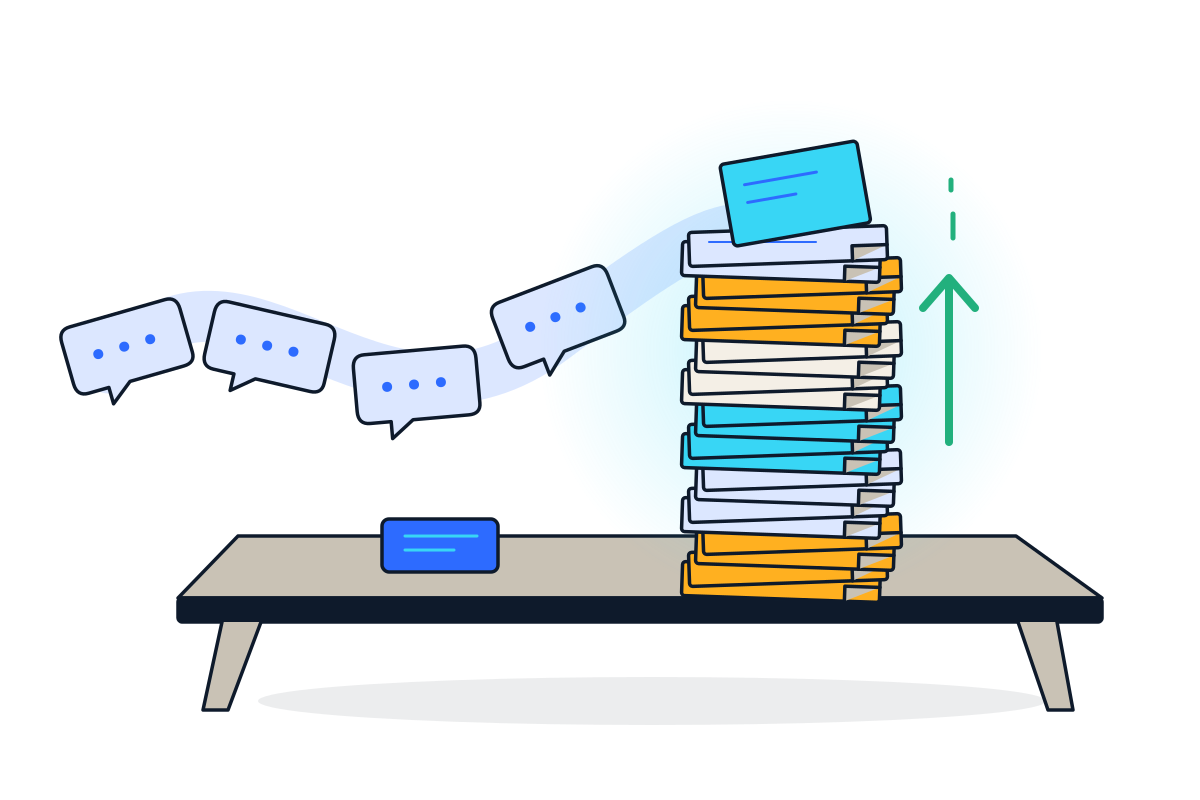
還記得第一場的「桌子」嗎?它在機器裡也要佔記憶體
小明要讀 5 篇文獻和報告,再加上畫圖程式的結果
→ 桌上的東西很多:桌子很大
→ 每讀一個字,就留一張便條紙 (這疊便條紙叫 KV cache)
| 模型 | 每個字一張便條紙 | 桌上放滿 128K 字 |
|---|
| 8B 模型Llama-3.1-8B | ≈ 0.13 MB | ≈ 17 GB |
| 70B 模型Llama-3.3-70B | ≈ 0.33 MB | ≈ 43 GB |
估算 部分 2026 年新模型(如 Gemma 4、gpt-oss)用了省便條紙的設計,會更省
①放得下嗎?
總記憶體公式
權重 + 每人便條紙 × 人數 + 10–20% 雜項
權重
便條紙(KV cache)
每人桌面 × 人數
雜項
再留一點餘裕:作業系統、框架、啟動暫存都要空間
「10–20% 雜項」為經驗值,不同軟體差異很大。
①放得下嗎?
互動
一起算:研究小組
要多少記憶體?70B 模型、壓到 4-bit。甲:5 人,每人桌上 40K 字(長報告) 乙:25 人,每人 8K 字
權重70.6B × 4.85 bit ÷ 84-bit 實際約 4.85 bit(多抓一點)≈ 43 GB
便條紙甲 5×40K 字=204,800 字;乙 25×8K 字=204,800 字(一樣多)每字約 0.33 MB(估算)≈ 67 GB
雜項再加 10–20%+10–20%
合計甲、乙一樣大,大約需要120 GB 以上
✗ 32GB 卡(RTX 5090)
✗ 96GB 卡(RTX PRO 6000)
→ 要更大的記憶體,或多卡
按 → 逐行揭曉 · 估算
①記憶體計算機
互動
0GB估算
權重 0 GB + 便條紙 0 GB + 15% 雜項 (;KV /token)
權重KV cache雜項右欄速度=單人理論上限(估算)
△=放得下但超過容量 9 成,需實測 · Strix Halo 頻寬為推算 · DGX Station 超過 GPU 252GB 時改以 CPU 396 GB/s 估 · B200 頻寬為 8 卡合計 · 估算。速度=單人理論上限,只算頻寬、未計算力上限;超過 200 tok/s 一律顯示 200+,請以實測為準。
②跑得多快?
為什麼「頻寬」決定打字速度?
每秒打幾個字 ≈
輸送帶速度 ÷ 每個字要搬的貨量單人對話、理論上限;實際會更低
每打一個字,要把整個模型搬一趟。
MoE 只搬用到的那幾個書架。
②跑得多快?
互動
賽跑:同一個 70B(4-bit,≈43GB)估算
按「開跑」,看 12 秒內各打出多少字
DGX Spark273 GB/s → ≈ 6 tok/s
0
Mac Studio M5 Ultra1.2 TB/s → ≈ 28 tok/s
0
RTX PRO 60001,792 GB/s → ≈ 42 tok/s
0
H2004.8 TB/s → ≈ 112 tok/s
0
速度=頻寬 ÷ 43GB,理論上限
②跑得多快?
同一台 DGX Spark,換個模型 估算
一般模型(每次全部書架都翻)
Gemma 4 31B(4-bit)
每個 token 讀 ≈ 19 GB 全部書架
14tok/s
MoE(每次只翻幾個書架)
gpt-oss-120b(官方 4-bit 格式)
每個 token 只讀 ≈ 5 GB 用到的書架(5.1B)
54tok/s
273 GB/s ÷ 19 GB ≈ 14 · 273 GB/s ÷ 5.1 GB ≈ 54(理論上限;社群實測約 50)
●硬體一覽
硬體級距(一):個人級
| 代表機型 | 記憶體(放得下) | 頻寬(跑多快) | 公開價格(2026-10) |
|---|
| 筆電/桌機 純 CPU一般電腦記憶體 | 16–64 GB | 89.6 GB/s理論值 · 估算 | — |
| AMD Ryzen AI Max+ 395Strix Halo | 最高 128 GB | 256 GB/s推算;實測約 212 | 機種差異大 |
| NVIDIA DGX Spark | 128 GB | 273 GB/s | US$6,950NVIDIA 官方商城 |
| Mac Studio M5 Ultra2026-08 發表 | 最高 512 GB | 1.2 TB/s | 起價 US$5,49996GB;512GB 版 US$22,299 |
| GeForce RTX 4090/5090消費級顯卡 | 24/32 GB | 1,008/1,792 GB/s | 5090 建議價 US$1,999市價遠高於此,常缺貨 |
●硬體一覽
硬體級距(二):部門級到機房級
| 代表機型 | 記憶體(放得下) | 頻寬(跑多快) | 公開價格(2026-10) |
|---|
| RTX PRO 6000 Blackwell工作站顯卡 | 96 GB | 1,792 GB/s | — |
| NVIDIA DGX Station桌邊工作站 | 748 GBGPU 252 + CPU 496 | 7.1 TB/sGPU 端 | 約 US$99k–181.5k歐洲經銷商報價 |
| H100 SXM/H200伺服器單卡 | 80/141 GB | 3.35/4.8 TB/s | — |
| AMD Instinct MI300X伺服器單卡 | 192 GB | 5.3 TB/s | — |
| NVIDIA DGX B2008 卡伺服器 | 1,440 GB | 64 TB/s8 卡合計 | US$559,950單一經銷商標價 |
●硬體一覽
一張圖:往右放得下,往上跑得快
個人/桌上 工作站 伺服器/機房速度線為估算
●例子:DGX 三兄弟
DGX 只是一個例子:用同一套方法讀規格
試驗 · 小規模試用 · MoE
DGX Spark
記憶體128 GB頻寬273 GB/s
US$6,9502026-10 NVIDIA 官方商城;首發後已調漲兩次
單人到小團隊的大模型
DGX Station
記憶體748 GB頻寬7.1 TB/s
US$99k–181.5kNVIDIA 不公告;歐洲經銷商 pi3g 報價(2026-10-30 更新)
機房 · 多人服務
DGX B200
記憶體1,440 GB頻寬64 TB/s
US$559,950NVIDIA 不公告;美國經銷商 Gatewell 標價(2026-10),僅供量級參考
同一套四個問題,換成 AMD、Apple、Dell 也一樣比
③幾個人用?
一個人用 vs 二十個人用
🚗 自用車
一次服務一個人:速度=頻寬上限,但機器大部分時間在等
🟧=一個人的便條紙(KV cache)
🚌 公車(批次處理)
伺服器軟體把多人的問題合併成一批一起算:總產量提高,但便條紙按人數倍增
🟧=一個人的便條紙(KV cache)
20.4–38.2%PagedAttention 論文:舊系統替便條紙預留的記憶體,
只有這麼多真的用到——新的伺服器軟體就是為此而生
③軟體怎麼選?
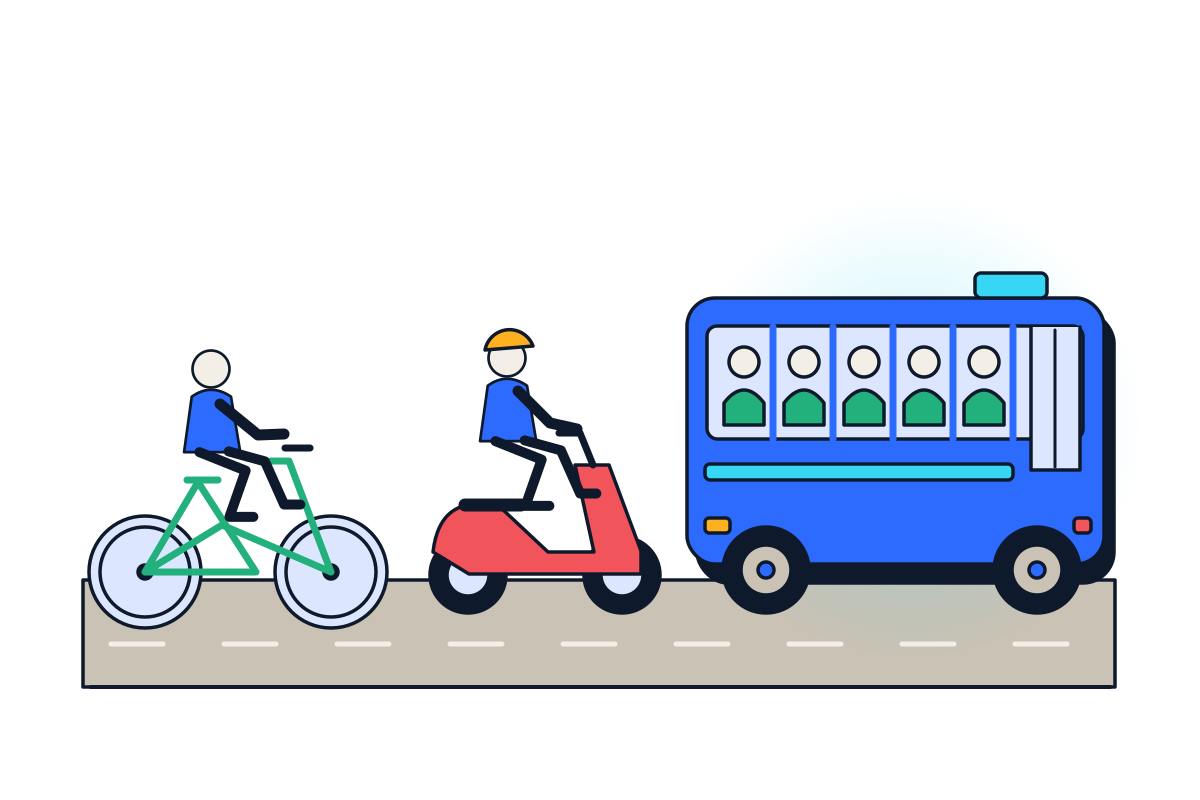
軟體:腳踏車 → 機車 → 公車
| 像什麼 | 情境 | 特點 |
|---|
| 🚲 腳踏車 | 一個人試用 | 裝好就能聊,有桌面介面LM Studio · Ollama |
| 🛵 機車 | 沒有大顯卡
的小機器 | CPU、顯卡一起出力,吃壓縮過的模型llama.cpp · GGUF 格式 |
| 🚌 公車 | 多人、正式上線 | 很多人的問題一起載;內部系統好接vLLM · OpenAI 相容 API |
③模型怎麼選?(2026-10)
綠燈名單:多大的機器能跑?
gpt-oss-20b
OpenAI · 美國
綠燈
16 GB 內官方:16GB 記憶體內可執行
→ 筆電、單張顯卡
gpt-oss-120b
OpenAI · 美國
綠燈
≈ 65 GB官方 4-bit 格式;單張 80GB 卡可跑
→ 96–128GB 等級機器
Gemma 4(31B)
Google · 美國
綠燈
≈ 19 GB4-bit 估算
→ 單張 24–32GB 顯卡
Mistral Small 4
Mistral · 法國
綠燈
≈ 72 GB4-bit 估算
→ 96–128GB 等級機器
Muse Glimmer 30B
Meta · 美國
綠燈
≈ 18 GB4-bit 估算
→ 單張 24–32GB 顯卡
TAIDE 12B
國科會 · 台灣
綠燈
≈ 8 GB4-bit 估算;授權見模型頁
→ 筆電
④換你幫組裡選
互動
換你幫組裡選:哪台機器適合?
分組討論 3 分鐘,再來連線
(A) 一位研究員離線讀技術文獻
(B) 5 人研究小組查 內部技術報告的問答(RAG)+ 整理比較表的 agent
(C) 全組共用、大量批次每天整批摘要報告+共用問答(示意)
多卡伺服器 + 公車型軟體量大:便條紙要很多,要和資訊單位談機房與電力
筆電或 Mac8B 級或 gpt-oss-20b
大記憶體桌上型或工作站DGX Spark/Mac Studio+MoE 模型
配對 0 / 3
④報價合理嗎?
帶回家:拿到報價,問這 8 題
1. 總記憶體多少?給 GPU 用的有多少?①容量
2. 記憶體頻寬多少(GB/s)?②速度
3. 目標模型與精度?權重要多大?①容量
4. 幾人同時用、context 多長、KV cache 多大?③人數
5. 單人 tok/s 和總吞吐量有沒有實測?②③
6. 功耗、電路、散熱、機櫃需求?例:20A 迴路
7. 軟體堆疊和授權?模型是否非陸資?合規
8. 保固、交期、擴充(能不能串接)?長期
✓小明的任務卡
互動
小明完成拼圖
小明的任務卡示意「請把這 5 篇 材料耐熱測試的文獻和報告整理成一張比較表,畫一張圖,再寫一頁摘要給組長。」
2
抓出關鍵數值和出處
接文獻庫S2
知道它在猜字+接文獻庫
3
照組內格式做比較表
SOP 手冊S2
組內 SOP 手冊
6
比較不同條件(溫度、材料)
桌面管理S1·S3
桌面管理
7
寫一頁摘要、給組長看
地端+簽名S3
地端機器+人簽名
小明的任務卡示意「請把這 5 篇 材料耐熱測試的文獻和報告整理成一張比較表,畫一張圖,再寫一頁摘要給組長。」
七格全亮:每一格都還是要人簽名
✓回顧
四步驟,帶得走
三場演講 · 結束
Q&A
Experts design, AI accelerates,
experts validate.